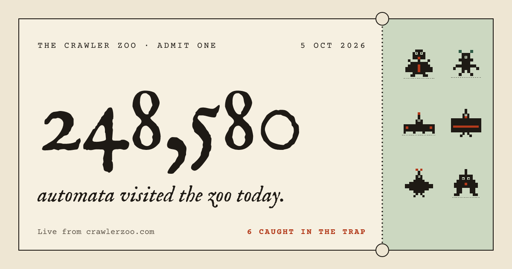
Gibt tatsächlich einige sehr interessante Insights. Man sieht zum beispiel welche Crawler sich an die robot.txt halten, welche sie ignorieren oder welche sogar explizit die verbotenen seiten aufrufen.
Überrascht hat mich: Google ist sehr brav. Hällt sich zu 100% an die robot.txt. Mastodon hingegen… Wo ich gutes erwartet hatte… Mastodon juckt das nicht und schaut sich alles an. Skurril. Der Mastodon crawler ist nur da für link previews. Warum schaut er sich so viel an.
Beim erstellen dieses Posts in Photon hab ich auch mal getestet wie die anfrage ankommt wenn man hier den Titel des Posts automatisch auslesen lässt. Lemmy oder zumindest Photon kommt als Masked Visitor rein. Gibt sich also als Mensch oder normaler Browser aus. Keine weitere Info daher auslesbar, weil das zusammen geworfen wird mit allen anderen anonymen Crawlern.
Super interessante seite. Kannst da auch irgendwie mit den Crawlern spielen. Dachte findet ihr vielleicht auch lustig.
Warum braucht Mastodon überhaupt einen Crawler? Ich hätte eigentlich vermutet, dass eine Link-Preview in dem Moment erzeugt wird, in dem ein Nutzer einen Link zu der entsprechenden URL teilt.